10 Probleme für Firmen mit KI-Gesetz und Datenschutz
10 vướng mắc của doanh nghiệp với Luật AI và bảo vệ dữ liệu
This reading was translated and simplified for German learners. The original content belongs to Tia Sang - Nen Tang Kien Tao.
Select a word or phrase to look it up, translate it, highlight it, or add a note.
Reading progress
Paragraph 1/24
Read the German first. Reveal the translation below any paragraph when needed.
Vietnamese translation
Mở đầu: Luật là bước tiến nhưng doanh nghiệp gặp khó
Vietnamese translation
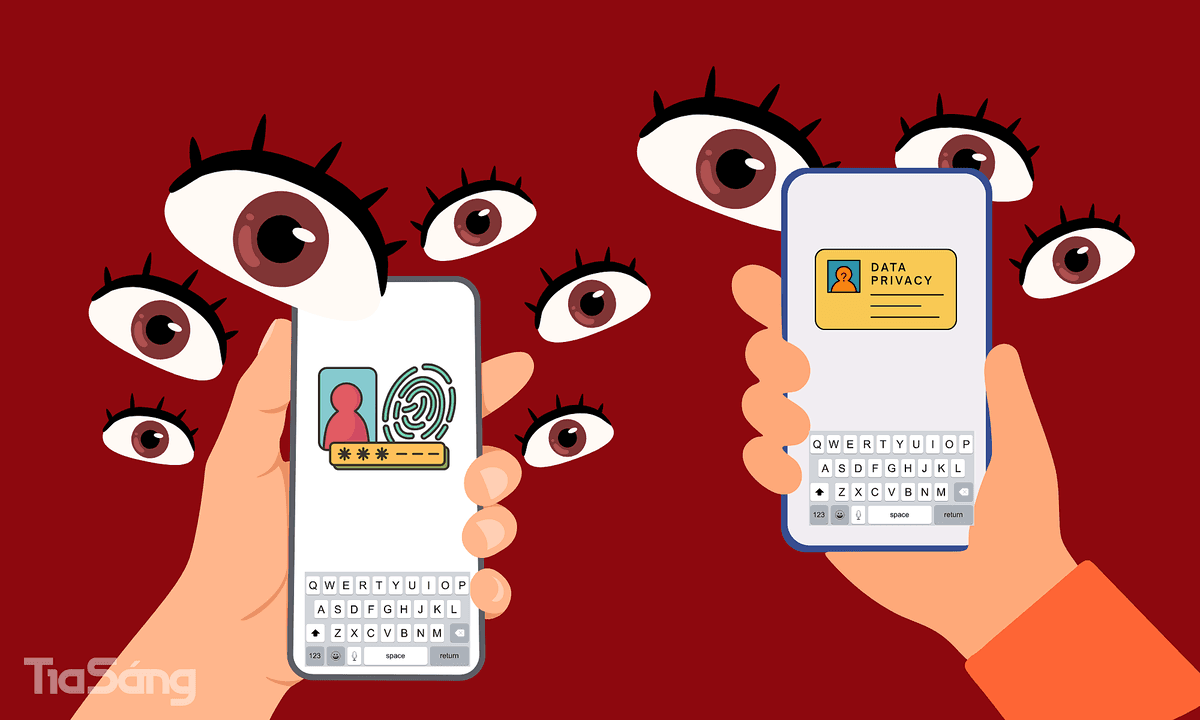
Đầu năm 2026, Việt Nam có hai luật quan trọng chính thức có hiệu lực: Luật Bảo vệ dữ liệu cá nhân và Luật Trí tuệ nhân tạo (AI). Kèm theo là loạt quy định mới, đặc biệt về Big Data - những tập dữ liệu cực lớn. Các quy định này rất chặt chẽ.
Vietnamese translation
Tác giả là chuyên gia về dữ liệu và huấn luyện AI, quan tâm đến quyền con người và quyền riêng tư. Ông từng nhiều lần viết về rủi ro khi thuật toán giám sát con người. Ông đánh giá tích cực hai luật mới. Theo ông, điều này cho thấy giới làm chính sách đã thấy rõ tầm quan trọng của khung pháp lý trong thời đại số.
Vietnamese translation
Tuy nhiên, doanh nghiệp đang vướng ở chỗ phải tuân thủ đồng thời cả hai luật. Về mặt kỹ thuật, nhiều yêu cầu không thể thực hiện cùng lúc. Dù thiện chí và đầu tư nhiều tiền, doanh nghiệp vẫn khó đáp ứng trọn vẹn. Bài viết nêu 10 vướng mắc, bắt đầu từ vấn đề lớn nhất.
Vietnamese translation
Vấn đề 1: Thu thập dữ liệu công khai để huấn luyện AI
Vietnamese translation
Đây là vướng mắc khó nhất với doanh nghiệp. Nếu không có hướng tháo gỡ, ngành AI trong nước sẽ chịu ảnh hưởng nặng.
Vietnamese translation
Điều 7 Luật AI quy định không được thu thập và sử dụng dữ liệu vi phạm Luật Bảo vệ dữ liệu cá nhân, quyền sở hữu trí tuệ hay an toàn an ninh mạng. Quy định áp dụng cho cả giai đoạn phát triển lẫn vận hành AI.
Vietnamese translation
Điều 9 Luật Bảo vệ dữ liệu cá nhân yêu cầu phải có sự đồng ý mới được xử lý thông tin cá nhân. Sự đồng ý phải rõ ràng, tự nguyện và thể hiện khẳng định, cho từng mục đích riêng biệt. Quy tắc 356 còn siết chặt hơn: chỉ được dùng Big Data cho mục đích rõ ràng và xác định.
Vietnamese translation
Muốn xây một mô hình ngôn ngữ lớn (LLM), cần hàng tỷ token tiếng Việt. Token là đơn vị nhỏ của văn bản. Cách khả thi duy nhất hiện nay là web scraping - thu thập tự động các thông tin công khai trên mạng. Quá trình này chắc chắn kéo theo tên, email, quan điểm cá nhân hay ảnh chụp vốn nằm trong bài viết và bình luận.
Vietnamese translation
Hiểu luật theo nghĩa chặt nhất, doanh nghiệp phải có sự đồng ý rõ ràng và tự nguyện cho từng mẩu thông tin như vậy. Tức là phải đi hỏi hàng triệu người: “Bạn có cho phép dùng dữ liệu của mình để huấn luyện AI không?” Việc này không khả thi.
Vietnamese translation
Việt Nam hiện chưa có cơ chế như “Fair Use” (sử dụng hợp lý) hay “Legitimate Interest” (lợi ích chính đáng) để linh hoạt xử lý trường hợp này. EU đã có hai khái niệm đó và áp dụng khá mềm dẻo trong luật AI của mình.
Vietnamese translation
Quan điểm cá nhân của tác giả: Đây là vùng xám khó nhất. Khi luật được hiểu theo hướng nghiêm ngặt nhất mà chưa có giải pháp kỹ thuật để kiểm tra từng nguồn trên mạng, doanh nghiệp rơi vào thế bất an. Họ lo phải xóa bỏ mô hình AI đã đầu tư hàng triệu USD.
Vietnamese translation

Vietnamese translation
Ảnh: Mỹ Hạnh
Vietnamese translation
Vấn đề 2: Giới hạn kỹ thuật của quyền được lãng quên
Vietnamese translation
Từ đầu năm 2026, mọi công dân Việt Nam có quyền yêu cầu xóa dữ liệu cá nhân của mình khỏi mọi hệ thống. Quy tắc 356 quy định doanh nghiệp phải phản hồi trong 2 ngày làm việc và hoàn tất việc xóa trong 20 ngày.
Vietnamese translation
Với cơ sở dữ liệu thông thường, yêu cầu này không có gì bất thường. Kỹ thuật viên chỉ cần chạy một lệnh như DELETE FROM users WHERE id = ... là xong.
Vietnamese translation
Với hệ thống AI, đặc biệt là mô hình ngôn ngữ (LM - Language Model), quy định trên gần như không thể đáp ứng về mặt kỹ thuật. Thông tin khi đã đưa vào AI giống như dòng chảy một chiều, rất khó truy ngược.
Vietnamese translation
Trong mạng nơ-ron đã huấn luyện, thông tin cá nhân không còn ở dạng văn bản đọc được. Chúng đã chuyển thành một phần của hàng tỷ trọng số toán học (weights và biases) và phân tán khắp mô hình. Việc bóc tách và xóa riêng dữ liệu của một người mà không làm hỏng mô hình là cực kỳ khó. Giới chuyên môn gọi đây là bài toán Machine Unlearning. Đến tháng 5/2026, thế giới vẫn chưa có lời giải trọn vẹn.
Vietnamese translation

Vietnamese translation
Trong mạng nơ-ron đã huấn luyện, dữ liệu cá nhân không còn ở dạng văn bản mà đã hòa vào hàng tỷ trọng số toán học phân tán khắp mô hình. Ảnh: Magnific.
Vietnamese translation
Trục trặc phổ biến nhất khi buộc mô hình “quên” là catastrophic forgetting - hiện tượng quên lan. Cố xóa một thông tin lại khiến mô hình mất luôn những khả năng khác không liên quan. Cách an toàn duy nhất là huấn luyện lại từ đầu (retrain). Với mô hình cỡ vừa, chi phí máy tính cho việc này lên tới hàng trăm nghìn đến hàng triệu USD.
Vietnamese translation
Làm sao một doanh nghiệp vừa và nhỏ xoay xở huấn luyện lại mô hình lớn chỉ trong 20 ngày? Câu trả lời, theo đánh giá của tác giả dựa trên năng lực kỹ thuật và hạ tầng ở Việt Nam tại thời điểm viết bài, là không thể.
Vietnamese translation
Quan điểm cá nhân của tác giả: Đây là ví dụ điển hình cho việc dùng khung pháp lý cũ để quản lý công nghệ mới. Theo tác giả, cần tìm hướng tiếp cận khác.