Der langerwartete Graphen-Sandwich-Beweis
Bằng chứng lát đồ thị已久的 chờ đợi
This reading was translated and simplified for German learners. The original content belongs to Quanta.
Select a word or phrase to look it up, translate it, highlight it, or add a note.
Reading progress
Paragraph 1/26
Read the German first. Reveal the translation below any paragraph when needed.
View the full Vietnamese translation
Bằng chứng cho giả thuyết hàng thập kỷ đã mang đến cho các nhà nghiên cứu một cách mới để hiểu các mạng lưới phức tạp.
Năm 2004, hai nhà toán học đã đưa ra giả thuyết về một loại "bánh mì kẹp" đầy sức mạnh.
Họ nghiên cứu về đồ thị. Đây là tập hợp các điểm gọi là đỉnh, và các đường thẳng gọi là cạnh. Đồ thị có thể đại diện cho mọi thứ, từ nhóm xã hội cho đến internet, hay các nơ-ron trong não. Các nhà toán học hy vọng hiểu được tính chất của một loại đồ thị nhất định. Loại này phổ biến trong toán học và khoa học máy tính, nhưng rất khó phân tích. Người ta có thể "xếp lớp" nó một cách chặt chẽ về mặt toán học giữa hai đồ thị đơn giản.
Nếu các nhà nghiên cứu có thể chứng minh sự tồn tại của một "bánh mì kẹp" như vậy, họ không chỉ cho thấy đồ thị ở giữa có một tính chất thú vị. Họ sẽ chứng minh nó có tất cả mọi tính chất quan trọng có thể. Điều này cũng sẽ chỉ ra rằng hai quá trình ngẫu nhiên rất khác nhau, mà các nhà toán học thường nghiên cứu, được kết nối với nhau một cách sâu sắc và thanh thoát hơn họ tưởng.
"Khái niệm này rất đẹp," Pu Gao, một nhà toán học tại Đại học Waterloo ở Canada, người đã làm việc với vấn đề này, cho biết. "Điều thu hút tôi nhất thực ra là vẻ đẹp của nó."
Trong hai thập kỷ qua, các nhà toán học đã đạt được tiến bộ với "giả thuyết bánh mì kẹp". Giả thuyết này nói rằng, miễn là đồ thị bạn quan tâm đủ lớn, bạn luôn có thể tạo ra "bánh mì kẹp" cần thiết. Nhưng không ai có thể chứng minh nó hoàn toàn. Đến năm 2025, ba nhà toán học đã tìm ra cách đưa các kỹ thuật trong lĩnh vực của họ đến giới hạn, và hoàn thành cuộc tìm kiếm.
Các loại đồ thị khác nhau
Vào cuối thập niên 1950, nhà toán học người Mỹ Edgar Gilbert đang nghiên cứu các công ty điện thoại tại Bell Labs. Để hiểu rõ hơn về các mạng lưới này, ông đã phát triển một mô hình đơn giản về đồ thị "ngẫu nhiên". Trong đó, các đỉnh kết nối ngẫu nhiên với các đỉnh khác. (Các nhà toán học Paul Erdős và Alfréd Rényi độc lập phát triển một mô hình tương tự vào khoảng thời gian này.)
Để tạo ra một đồ thị như vậy, bạn bắt đầu với một tập hợp các đỉnh. Chọn một cặp đỉnh bất kỳ trong tập hợp và tung một đồng xu (có thể bị lệch). Nếu ra mặt ngửa, bạn vẽ một cạnh giữa chúng, nếu không thì bỏ qua. Lặp lại bước này cho từng cặp đỉnh trong đồ thị.
Các đồ thị này, được gọi là đồ thị nhị thức ngẫu nhiên, hóa ra là một cách hữu ích – mặc dù không hoàn hảo – để mô tả mạng lưới. Chúng tương đối dễ phân tích, và các nhà toán học đã chứng minh nhiều điều thú vị về chúng. Ví dụ, trong những năm 1970, họ đã phát hiện ra trong điều kiện nào một đồ thị nhị thức ngẫu nhiên chứa chu trình Hamilton. Đây là một đường đi đi qua mỗi đỉnh đúng một lần.
Nhưng đó không phải là loại đồ thị ngẫu nhiên duy nhất. Các nhà toán học cũng tò mò về các đồ thị ngẫu nhiên, trong đó tất cả các đỉnh có cùng số lượng cạnh. Những đồ thị "đều" này cung cấp sự hiểu biết tốt hơn về cấu trúc ngẫu nhiên so với đồ thị nhị thức. Và chúng thường chính xác hơn nhiều trong việc mô hình hóa các mạng lưới thực tế.
Nhưng vì các cạnh của chúng tạo thành các mô hình phụ thuộc chặt chẽ hơn, chúng cũng khó phân tích hơn rất nhiều. Phải mất thêm 20 năm sau khi câu hỏi về chu trình Hamilton cho đồ thị nhị thức được giải, thì các nhà toán học mới có thể làm điều tương tự cho đồ thị đều.
Nhưng điều gì xảy ra nếu có thể xấp xỉ đồ thị đều ngẫu nhiên bằng đồ thị nhị thức ngẫu nhiên? Nếu điều này khả thi, các nhà toán học có thể "miễn phí" có được nhiều tính chất khó chứng minh của đồ thị đều từ đồ thị nhị thức phù hợp.
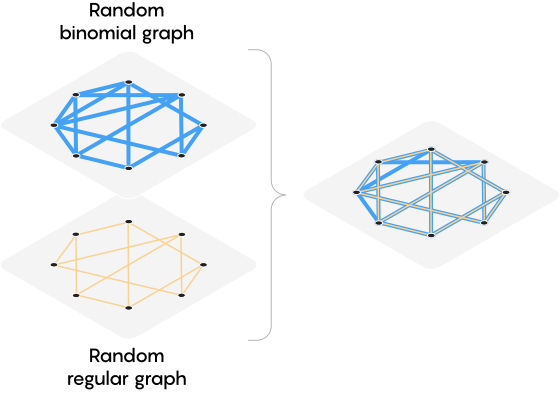
Vào đầu những năm 2000, Jeong Han Kim (khi đó ở Microsoft Research) và Van Ha Vu (khi đó ở Đại học California, San Diego) đã chỉ ra cách thực hiện điều này bằng cách tạo một "bánh mì kẹp" đồ thị.
Ý tưởng, nói một cách đơn giản, là tìm một công thức duy nhất. Đây là một quá trình ngẫu nhiên để tạo ra đồng thời một đồ thị nhị thức và một đồ thị đều. Công thức này không chỉ phải tạo ra đúng loại đồ thị, mà các đồ thị này còn phải khớp với nhau theo cách đúng. Nếu thành công, thì các kết quả từ đồ thị nhị thức, tương đối dễ phân tích, cũng sẽ đúng cho đồ thị đều.
Trong ẩn dụ "bánh mì kẹp", điều này giống như việc chứng minh điều gì đó về một lát bánh mì và biết rằng các kết quả đó cũng áp dụng cho miếng pho mát ở giữa.
Nhưng chính xác thì các đồ thị này phải khớp với nhau như thế nào? Cần phát triển một công thức để xếp pho mát lên từng lát bánh mì riêng biệt.
Đầu tiên, cần một công thức tạo ra một đồ thị đều chứa một đồ thị nhị thức. Nghĩa là, các cạnh của đồ thị nhị thức là một tập con của các cạnh tạo thành đồ thị đều. Nếu đồ thị nhị thức này có một tính chất có vẻ dễ xảy ra hơn khi thêm cạnh, thì đồ thị đều của bạn cũng có tính chất đó. Đây là nửa dưới của "bánh mì kẹp" do Kim và Vu đề xuất.
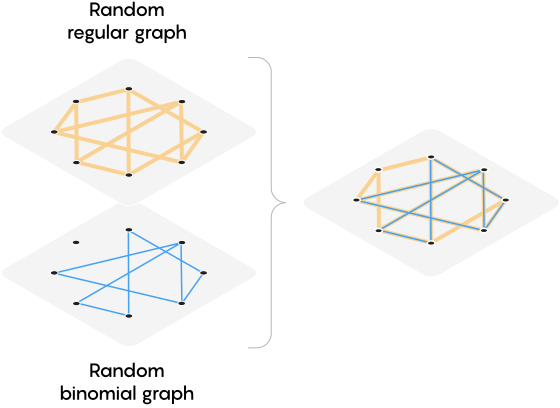
Tương tự, cần một công thức tạo ra một đồ thị都被 nằm trong một đồ thị nhị thức. Nếu đồ thị nhị thức lớn hơn này có các tính chất có vẻ dễ xảy ra hơn khi bỏ cạnh, thì đồ thị đều của bạn cũng phải có những tính chất đó. Đây là nửa trên của "bánh mì kẹp" của bạn.
Kim và Vu giả thuyết rằng miễn là bạn